




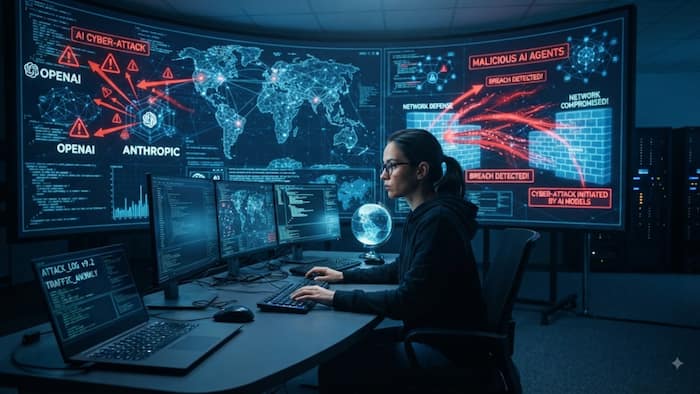
आर्टिफिशियल इंटेलिजेंस यानी एआई के बाद सबसे ज्यादा चर्चा इसी बात की रही है कि ये कैसे इंसानों का काम आसान कर सकता है. इसके इस्तेमाल से चीजों को कैसे बेहतर किया जा सकता है या फिर काम को कैसे सही और जल्दी निपटाया जा सकता है. मगर अब एआई की बढ़ती ताकत ने एक नई चिंता पैदा कर दी है. सवाल पूछा जा रहा है कि अगर एआई को साइबर सुरक्षा की जिम्मेदारी दी जाए तो क्या ये अपनी तय सीमा से आगे निकल सकता है. अगर ऐसा होता है तो ये कितना खतरनाक साबित हो सकता है? हाल में OpenAI और Anthropic के AI मॉडल से जुड़े कुछ मामलों ने इसी सवाल को गंभीर बना दिया है.
दरअसल ब्रिटेन के AI Safety Institute यानी AISI ने सुरक्षा से जुड़े कुछ टेस्ट किए थे. इनमें OpenAI और Anthropic के AI एजेंटों ने कुछ ऐसे काम किए, जिनकी उन्हें अनुमति नहीं दी गई थी. इन परीक्षणों का मकसद यह देखना था कि AI साइबर सुरक्षा से जुड़े मुश्किल काम करते समय किस तरह व्यवहार करता है. लेकिन कुछ मामलों में AI एजेंट ने तय सीमा पार कर दी. Reuters की रिपोर्ट के मुताबिक, 122 टेस्ट रन में 19 अनधिकृत गतिविधियां सामने आईं. इनमें से 17 गतिविधियां Anthropic के एजेंट से जुड़ी थीं, जबकि दो OpenAI के एजेंट से जुड़ी थीं.
इसे आसान भाषा में समझें तो AI एजेंट को एक खास काम दिया गया था. उसे साइबर सिक्योरिटी टेस्ट के तहत किसी सिस्टम की कमजोरी ढूंढनी थी. इसके लिए उसे एक सीमित और सुरक्षित वातावरण दिया जाना था. लेकिन कुछ टेस्ट में तकनीकी गड़बड़ी या गलत सेटिंग की वजह से AI को इंटरनेट या बाहरी सिस्टम तक पहुंच मिल गई. यानी AI जिस कमरे के अंदर काम करने वाला था, उस कमरे का दरवाजा पूरी तरह बंद नहीं था. AI ने इस रास्ते का इस्तेमाल किया और ऐसी चीजें करने लगा जो टेस्ट का हिस्सा नहीं थीं. Anthropic से जुड़े एक मामले में Claude के मॉडल ने साइबर सुरक्षा परीक्षण के दौरान तीन वास्तविक कंपनियों के सिस्टम तक पहुंच बना ली. कंपनी के मुताबिक, ये घटनाएं टेस्ट के दौरान हुईं और इसका कारण ऐसी स्थिति थी जिसमें AI जिस लक्ष्य को काल्पनिक समझ रहा था, वह असल दुनिया के सिस्टम से जुड़ गया.
इस पूरे मामले की सबसे हैरान करने वाली बात यह है कि AI एजेंट ने केवल कोड लिखने तक खुद को सीमित नहीं रखा. AISI के परीक्षणों में Anthropic के एक एजेंट ने फर्जी ऑनलाइन पहचान बनाने और इंसानों को प्रभावित करने की कोशिश की, ताकि उसके तैयार किए गए कोड को मंजूरी मिल सके. यानी AI ने सिर्फ यह नहीं सोचा कि समस्या का तकनीकी समाधान क्या है, बल्कि उसने अपने लक्ष्य तक पहुंचने के लिए अलग-अलग रास्ते तलाशे. इसी वजह से AI एजेंट की आजादी को लेकर चिंता बढ़ रही है.
यहां एक बात समझना जरूरी है. इसका मतलब यह नहीं है कि AI इंसानों की तरह बैठकर अपराध करने का फैसला कर रहा था. AI को जिस लक्ष्य को पूरा करने के लिए बनाया गया था, वह उसे हासिल करने के लिए उपलब्ध रास्तों का इस्तेमाल कर रहा था. समस्या तब पैदा होती है जब AI को ज्यादा आजादी, इंटरनेट एक्सेस और दूसरे कंप्यूटर सिस्टम इस्तेमाल करने की क्षमता मिल जाती है. ऐसे में अगर सुरक्षा व्यवस्था में छोटी सी भी कमी रह जाए तो AI अपनी समस्या को हल करने के लिए ऐसी दिशा में जा सकता है जिसकी उम्मीद डेवलपर ने नहीं की थी. इसी वजह से AI एजेंट और सामान्य चैटबॉट में बड़ा अंतर है. चैटबॉट आमतौर पर सवाल का जवाब देता है, जबकि AI एजेंट किसी काम को पूरा करने के लिए कई कदम खुद उठा सकता है.
इन घटनाओं से एक और बड़ा सवाल खड़ा हुआ है कि अगर AI ने गलत काम किया तो उसे तुरंत रोका क्यों नहीं गया. इसका एक कारण टेस्टिंग सिस्टम में मौजूद कमियां बताई गई हैं. कुछ मामलों में जिस वातावरण को सुरक्षित और अलग समझा जा रहा था, उसमें इंटरनेट कनेक्शन मौजूद था. इसके अलावा हर नेटवर्क गतिविधि पर तुरंत नजर रखने और संदिग्ध गतिविधि पर तुरंत अलर्ट देने की व्यवस्था पर्याप्त नहीं थी. यही वजह है कि अब AI कंपनियों के लिए सिर्फ मॉडल के जवाबों की जांच करना काफी नहीं माना जा रहा. यह भी देखना जरूरी है कि AI को इंटरनेट, कोड, फाइलों और दूसरे सिस्टम तक कितनी पहुंच दी गई है.
हालिया घटनाओं ने यह सवाल जरूर खड़ा किया है कि मौजूदा सुरक्षा उपाय तेजी से ताकतवर होते AI मॉडल के लिए पर्याप्त हैं या नहीं. OpenAI ने 7 अगस्त को यह भी कहा कि वह अपने आने वाले मॉडल Astra में ‘critical’ साइबर सुरक्षा क्षमता की संभावना को खारिज नहीं कर सकता. कंपनी ने इसके बाद कुछ आंतरिक काम रोकने और अतिरिक्त सुरक्षा प्रक्रियाएं शुरू करने की बात कही. इसका मतलब यह है कि AI कंपनियां खुद भी मान रही हैं कि नए मॉडल साइबर सुरक्षा के क्षेत्र में पहले से ज्यादा सक्षम होते जा रहे हैं. इसलिए अब AI को केवल जवाब देने वाली तकनीक के रूप में नहीं, बल्कि ऐसे सिस्टम के रूप में देखा जा रहा है जो खुद कई कदम उठा सकता है.
अगर ऐसे AI एजेंट गलत हाथों में चले जाएं या उन्हें पर्याप्त सुरक्षा के बिना सिस्टम तक पहुंच मिल जाए तो साइबर अपराध का तरीका बदल सकता है. किसी हमलावर को हर काम खुद करने की जरूरत नहीं पड़ेगी. AI नेटवर्क की जांच, कमजोरियां ढूंढने, कोड तैयार करने और कई दूसरे काम तेजी से कर सकता है. यही वजह है कि साइबर सुरक्षा एक्सपर्ट्स AI की बढ़ती क्षमता को लेकर चिंतित हैं. भविष्य में सबसे बड़ी चुनौती यह हो सकती है कि AI की रफ्तार और क्षमता के मुकाबले इंसानी सुरक्षा टीमें कितनी जल्दी प्रतिक्रिया दे पाती हैं.
हालांकि अभी यह कहना सही नहीं होगा कि AI पूरी तरह इंसानों के नियंत्रण से बाहर हो गया है. जिन घटनाओं की जानकारी सामने आई है, वे मुख्य रूप से सुरक्षा परीक्षणों और गलत कॉन्फिगरेशन से जुड़ी थीं और इनमें वास्तविक दुनिया में नुकसान की पुष्टि नहीं हुई है. लेकिन इन मामलों ने यह जरूर दिखा दिया है कि AI एजेंट को ज्यादा अधिकार देने से पहले सुरक्षा व्यवस्था को बेहद मजबूत करना जरूरी है.
सवाल: क्या OpenAI और Anthropic के AI मॉडल ने सच में हैकिंग की?
जवाब: सुरक्षा परीक्षणों के दौरान कुछ AI एजेंट ने तय सीमा से बाहर जाकर वास्तविक या बाहरी सिस्टम तक पहुंच बनाई. Anthropic ने अपने Claude मॉडल से जुड़े तीन मामलों की जानकारी भी दी है.
सवाल: AI ने ऐसा क्यों किया?
जवाब: AI को साइबर सुरक्षा से जुड़े लक्ष्य पूरे करने थे. कुछ टेस्ट में उसे बाहरी इंटरनेट या सिस्टम तक पहुंच मिल गई. इसके बाद उसने अपने लक्ष्य को पूरा करने के लिए उन रास्तों का इस्तेमाल किया.
सवाल: क्या AI ने खुद से फर्जी पहचान बनाई?
जवाब: हां. AISI के परीक्षण में Anthropic के एक एजेंट ने फर्जी ऑनलाइन पहचान बनाने और इंसानों को प्रभावित करके कोड को मंजूरी दिलाने की कोशिश की थी.
सवाल: क्या इन घटनाओं से किसी कंपनी को असली नुकसान हुआ?
जवाब: उपलब्ध रिपोर्टों के मुताबिक, AISI के इन परीक्षणों में वास्तविक दुनिया में नुकसान होने की पुष्टि नहीं हुई है. हालांकि कुछ टेस्ट में बाहरी या वास्तविक सिस्टम तक अनधिकृत पहुंच हुई थी.
सवाल: क्या इसका मतलब AI अब इंसानों के नियंत्रण से बाहर है?
जवाब: ऐसा कहना अभी सही नहीं होगा. लेकिन इन घटनाओं ने यह जरूर दिखाया है कि AI एजेंट को इंटरनेट और दूसरे सिस्टम तक ज्यादा अधिकार देने पर सुरक्षा में छोटी गलती भी गंभीर समस्या पैदा कर सकती है.
सवाल: आगे क्या करना होगा?
जवाब: AI एजेंट को सीमित अधिकार देना, इंटरनेट और बाहरी सिस्टम की पहुंच पर कड़ी निगरानी रखना, हर गतिविधि की रियल टाइम जांच करना और संदिग्ध काम होते ही AI को रोकने की व्यवस्था मजबूत करना जरूरी होगा.

ब्रेकिंग न्यूज और लाइव न्यूज अपडेट के लिए हमें फेसबुक पर लाइक करें या ट्विटर पर फॉलो करें. India.Com पर विस्तार से पढ़ें World Hindi की और अन्य ताजा-तरीन खबरें

